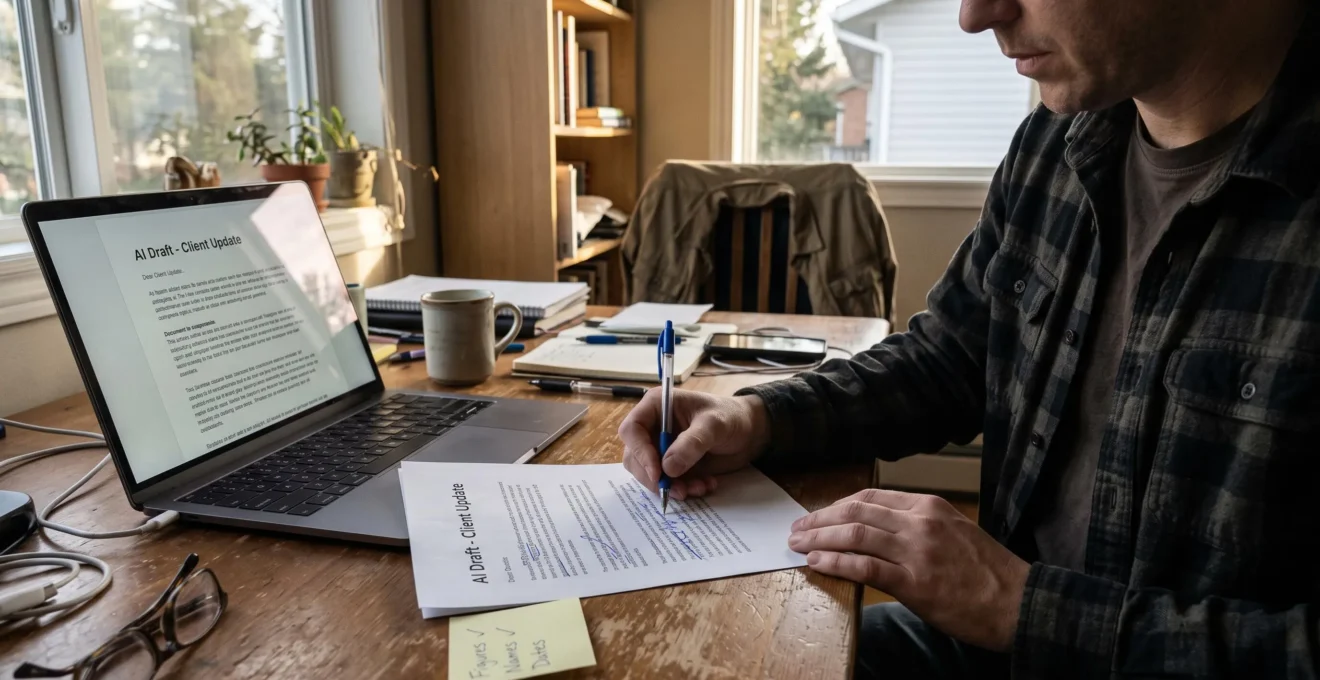
Un assistant d’intelligence artificielle peut préparer un courriel, résumer un document, organiser des idées ou proposer un plan de travail en quelques instants. Pourtant, sa rapidité ne garantit ni l’exactitude de ses réponses ni leur pertinence dans une situation particulière. Le véritable enjeu consiste à profiter de cette capacité d’exécution sans lui transférer la responsabilité des choix importants.
Pour un particulier ou un professionnel au Canada, la distinction devient essentielle dès qu’une tâche concerne des données personnelles, des engagements financiers, des obligations professionnelles ou une décision difficile à corriger. Une formulation convaincante peut masquer une erreur factuelle. Une automatisation pratique peut exposer une information confidentielle. Un résultat apparemment satisfaisant peut aussi demander davantage de corrections que prévu.
La méthode la plus utile repose sur une règle simple : déléguer la préparation et les tâches répétitives, conserver la vérification et le jugement. Cela suppose de choisir les bons usages, de formuler des consignes précises et d’adapter le contrôle aux conséquences possibles d’une erreur.
Utiliser l’IA sans perdre le contrôle : l’essentiel
- Confier à l’IA les brouillons, reformulations, classements et préparations faciles à vérifier, plutôt que les décisions irréversibles.
- Contrôler en priorité les faits, chiffres, sources, données sensibles et engagements avant toute utilisation réelle.
- Évaluer le temps gagné après les corrections et conserver une validation humaine proportionnée au risque.
- Pourquoi une intelligence artificielle peut-elle affirmer une information fausse avec assurance ?
- Comment formuler une consigne à une IA quand le résultat attendu comporte plusieurs contraintes ?
- IA ou traitement manuel : que déléguer quand une erreur aurait des conséquences importantes ?
- Quelle donnée éviter d’envoyer à un assistant IA utilisé dans un contexte professionnel ?
- Comment intégrer une étape de contrôle humain sans annuler le gain de temps obtenu avec l’IA ?
- Comment tester une nouvelle application ou IA pendant une semaine sans perturber son organisation actuelle ?
- Quelle information personnelle éviter d’utiliser comme réponse de sécurité ?
- Comment le chiffrement protège-t-il vos données quand elles circulent sur internet, et ce que cela ne couvre pas ?
Pourquoi une intelligence artificielle peut-elle affirmer une information fausse avec assurance ?
Une intelligence artificielle générative peut présenter une information fausse avec assurance parce qu’elle produit des réponses à partir de régularités apprises dans les données, sans disposer d’un mécanisme universel garantissant leur exactitude. Elle peut ainsi générer une explication crédible, un chiffre inventé ou une référence inexistante, même lorsque la formulation paraît précise et professionnelle.
Lorsqu’un modèle de langage rédige une réponse, il sélectionne successivement des éléments de texte selon des probabilités influencées par son entraînement et le contexte fourni. Ce mécanisme permet de construire des phrases cohérentes, mais la cohérence linguistique ne constitue pas une preuve. Même un modèle capable de rechercher des documents ou d’utiliser des outils peut mal interpréter les informations obtenues.
Ces erreurs sont parfois appelées « hallucinations ». Le rapport du NIST sur les risques de l’IA générative emploie notamment le terme « confabulation » pour décrire la production de contenus erronés ou faux présentés avec assurance.
Trois catégories méritent d’être distinguées, car elles ne se vérifient pas de la même façon :
- Information obsolète : l’IA utilise une règle, une fonction logicielle ou une information qui n’est plus à jour. Il faut consulter une source officielle récente.
- Information inventée : une étude, un lien, une citation ou un chiffre est présenté sans correspondre à une source réelle. Il faut retrouver le document original et contrôler son contenu.
- Information mal appliquée : une explication généralement correcte est utilisée dans un contexte inapproprié. Il faut vérifier les conditions particulières de la situation.
Supposons, à titre d’exemple hypothétique, qu’un assistant prépare une réponse sur les obligations d’une entreprise canadienne. Il pourrait mentionner une règle réellement applicable dans une province, puis la présenter comme valable partout au pays. La difficulté ne serait pas nécessairement l’invention de la règle, mais son application géographique incorrecte.
Le niveau de vérification doit donc suivre les conséquences possibles de l’erreur. Un texte créatif peut généralement se contenter d’une relecture. Une affirmation médicale, juridique ou financière exige une vérification indépendante auprès de sources compétentes. Une référence bibliographique doit être retrouvée, et tout calcul important doit être contrôlé.
Le ton assuré de l’assistant n’apporte aucune garantie supplémentaire. Une réponse hésitante peut être correcte, tandis qu’une réponse catégorique peut être fausse.
Cette limite ne rend pas l’IA inutile : elle précise son rôle. L’outil peut accélérer la recherche d’idées ou la préparation d’un contenu, tandis que la personne conserve la responsabilité de déterminer ce qui est vrai, pertinent et acceptable. Une consigne bien construite facilite ensuite cette séparation des tâches.
Comment formuler une consigne à une IA quand le résultat attendu comporte plusieurs contraintes ?
Pour obtenir un résultat respectant plusieurs contraintes, une consigne doit préciser l’objectif, le contexte, les règles prioritaires, le format attendu et les erreurs à éviter. Il vaut mieux hiérarchiser ces éléments plutôt que les accumuler dans une longue phrase. L’IA peut alors produire une première version plus facile à évaluer et à corriger.
Une demande comme « Rédige un bon courriel professionnel, court, clair et complet » laisse de nombreuses interprétations possibles. Que signifie « court » ? Quels renseignements sont indispensables ? Quel ton faut-il adopter ? La personne risque de devoir corriger plusieurs versions avant d’obtenir un texte utilisable.
Une consigne structurée peut suivre cinq couches :
- Objectif : indiquer l’action précise attendue, par exemple préparer un courriel de suivi après une rencontre.
- Contexte : préciser le destinataire, le sujet et les informations nécessaires, sans révéler de données confidentielles inutiles.
- Contraintes hiérarchisées : distinguer les exigences obligatoires des préférences secondaires.
- Format : demander un texte d’une longueur définie, un tableau ou une liste, selon l’utilisation prévue.
- Contre-exemples : indiquer explicitement les comportements interdits, comme inventer une date ou prendre un engagement non autorisé.
Voici un exemple pédagogique de consigne utilisable pour un courriel fictif :
Cas pratique : préparer un courriel de suivi
« Prépare un courriel professionnel destiné à une personne rencontrée récemment. Objectif : demander des nouvelles d’un dossier sans exercer de pression. Utilise un français canadien naturel et un ton courtois. Limite le corps du message à 100 mots. Inclus une formule d’ouverture, une demande précise et une formule de clôture. N’invente aucune date, promesse ou information absente du contexte. Si un renseignement manque, indique-le entre crochets. »
Le résultat attendu est un brouillon qui respecte des critères observables. La personne peut ensuite vérifier son contenu et personnaliser le message avant l’envoi.
Les bonnes pratiques de formulation des prompts publiées par OpenAI recommandent notamment des instructions claires, spécifiques et améliorées progressivement après examen des réponses.
Lorsqu’une tâche comprend plusieurs exigences, un test simple permet de détecter les contradictions. Avant d’utiliser de véritables informations professionnelles, il est possible d’essayer la consigne avec un destinataire fictif et de vérifier si la longueur, le ton et les interdictions sont respectés.
Après une première réponse, les corrections ciblées sont généralement plus faciles à évaluer qu’une nouvelle demande entièrement reformulée. Par exemple : « Conserve les deux premiers paragraphes, raccourcis la conclusion et supprime toute suggestion de rendez-vous. »
Cette approche ne garantit pas que toutes les contraintes seront suivies. Elle transforme toutefois des attentes vagues en critères explicites, ce qui rend les erreurs plus faciles à repérer.
La qualité du prompt dépend donc autant de la définition du résultat que de la formulation des phrases. Mais même un résultat conforme aux instructions ne doit pas nécessairement être utilisé : encore faut-il déterminer quelles tâches peuvent être confiées à l’IA sans risque excessif.
IA ou traitement manuel : que déléguer quand une erreur aurait des conséquences importantes ?
Lorsqu’une erreur pourrait avoir des conséquences importantes, il faut réserver à l’IA les étapes préparatoires qui restent vérifiables et réversibles. La décision finale, l’approbation et les engagements doivent rester sous contrôle humain. Pour arbitrer, trois critères suffisent généralement : la possibilité de corriger l’erreur, l’existence d’une vérification indépendante et son coût potentiel.
Une tâche ne devient pas automatiquement sûre parce qu’elle est simple ou répétitive. L’envoi d’un courriel, par exemple, peut sembler banal. Pourtant, une formulation inappropriée adressée à un client mécontent peut aggraver une situation commerciale. À l’inverse, préparer plusieurs variantes de ce même courriel présente moins de risques si aucune n’est envoyée automatiquement.
La grille suivante aide à choisir un mode de traitement proportionné aux enjeux.
| Critère | Délégation envisageable | Contrôle humain nécessaire |
|---|---|---|
| Réversibilité | Le résultat peut être modifié sans conséquence notable. | L’action est difficile à annuler ou produit un effet immédiat. |
| Vérification | Une source indépendante ou un critère objectif permet de contrôler rapidement le résultat. | La validité dépend d’une interprétation délicate ou d’informations incomplètes. |
| Coût de l’erreur | Une correction demande peu d’efforts et n’expose personne à un préjudice important. | L’erreur peut entraîner une perte financière, juridique, professionnelle ou relationnelle. |
Pour un courriel de relance ordinaire, l’IA peut produire une première version que son utilisateur adapte avant l’envoi. Pour une réponse à une réclamation, une offre contractuelle ou une candidature, elle peut aider à clarifier des formulations, mais les éléments sensibles doivent être examinés directement par la personne concernée.
La zone intermédiaire mérite une attention particulière. Elle concerne les tâches pour lesquelles l’IA prépare un document utilisable uniquement après une validation complète. Dans ce cas, il faut relire ligne par ligne les passages engageants et vérifier séparément les montants, les noms, les dates et les obligations annoncées.
Autre exemple hypothétique : un professionnel demande à l’IA de résumer plusieurs options d’achat pour son entreprise. L’outil peut comparer des caractéristiques et organiser des questions à poser aux fournisseurs. Il ne devrait pas approuver seul une dépense ni confirmer des conditions commerciales non vérifiées.
Le gain de temps doit aussi être mesuré correctement. Si la rédaction automatisée économise quelques minutes mais impose une longue correction, son intérêt pratique diminue. Lorsque le contrôle est aussi complexe que la tâche originale, le traitement manuel peut redevenir préférable.
Enfin, une délégation répétée sans incident peut créer un excès de confiance. Il est utile de reprendre périodiquement un échantillon de résultats et de le comparer aux informations d’origine, même lorsque l’automatisation semble bien fonctionner.
Cette frontière peut évoluer avec les outils, les procédures de contrôle et les conséquences possibles. Elle suppose néanmoins une condition préalable : les informations transmises à l’assistant doivent pouvoir être partagées sans compromettre leur confidentialité.
Quelle donnée éviter d’envoyer à un assistant IA utilisé dans un contexte professionnel ?
Dans un contexte professionnel, il faut éviter de transmettre à un assistant IA non autorisé les données personnelles des clients ou collègues, les informations de santé, les documents internes confidentiels, les secrets commerciaux et les identifiants d’accès. Les conditions de conservation et de traitement varient selon les services : un outil pratique ne devient pas automatiquement un environnement approuvé pour ces données.
Le problème ne se limite pas à la possibilité qu’un modèle réutilise des informations pour son entraînement. Selon le fournisseur, le type de compte, les paramètres et les engagements contractuels, les données peuvent faire l’objet de conservation, de traitements techniques ou d’accès encadrés par le service.
Une offre destinée aux entreprises peut présenter des garanties contractuelles et des contrôles différents de ceux d’un compte personnel. Ces garanties doivent être vérifiées plutôt que présumées. Une politique interdisant l’entraînement sur les données des clients ne signifie pas nécessairement que toute conservation ou tout traitement est exclu.
Dans la pratique, plusieurs catégories doivent être écartées d’un assistant non approuvé :
- Les renseignements permettant d’identifier directement ou indirectement un client, un collègue ou un partenaire.
- Les dossiers de santé, données financières individuelles et renseignements personnels sensibles.
- Les contrats non publics, propositions commerciales confidentielles et documents stratégiques de l’employeur.
- Les mots de passe, clés d’API, jetons d’authentification et autres secrets techniques.
- Les fichiers ou conversations dont la transmission à un fournisseur externe n’a pas été autorisée.
Au Canada, les obligations de protection des renseignements personnels dépendent notamment de l’organisation, de son activité et de la législation applicable. La Loi sur la protection des renseignements personnels et les documents électroniques (LPRPDE) encadre certaines activités du secteur privé, tandis que des lois provinciales peuvent également s’appliquer. Il faut notamment tenir compte des exigences propres au Québec et des règles sectorielles pertinentes.
Les principes du Commissariat à la vie privée du Canada sur l’IA générative recommandent notamment de recourir à des informations anonymisées ou désidentifiées dans les consignes lorsque cela est possible.
Une technique utile consiste à reformuler un problème plutôt qu’à copier son document d’origine. La désidentification doit toutefois être suffisamment complète pour empêcher une personne de reconnaître les individus concernés à partir du contexte.
Voici un exemple entièrement fictif. Une demande initiale pourrait mentionner : « Rédige une réponse à Marie Tremblay, cliente de l’entreprise ABC, au sujet de sa facture de 4 735 $ datée du 12 septembre. » Elle contient plusieurs détails potentiellement identifiants.
Une reformulation moins exposante serait : « Propose un modèle de réponse professionnelle à un client qui conteste une facture. Utilise des champs génériques pour les renseignements personnels, les montants et les dates. N’admets aucune responsabilité et ne promets aucun remboursement. » La personne réintroduira les éléments nécessaires dans son environnement de travail autorisé.
Cette précaution ne garantit pas toujours l’anonymat. Un événement rare, une fonction précise ou une combinaison de détails peut permettre une réidentification. Dans ces cas, il faut généraliser davantage ou renoncer à transmettre la situation à un service externe.
L’utilisation d’un compte personnel pour traiter des dossiers professionnels expose aussi l’organisation et potentiellement les personnes concernées. L’employé doit respecter les règles internes, tandis que l’organisation conserve les responsabilités qui lui incombent légalement. Avant toute utilisation, il faut vérifier la politique de l’employeur et la liste des outils autorisés.
La protection des informations commence donc avant la génération de la réponse. Une fois la tâche confiée à un outil approprié, un autre enjeu apparaît : comment contrôler le travail sans perdre tout le temps économisé ?
Comment intégrer une étape de contrôle humain sans annuler le gain de temps obtenu avec l’IA ?
Un contrôle humain efficace consiste à vérifier d’abord les éléments capables de provoquer les erreurs les plus coûteuses, plutôt qu’à relire chaque mot avec la même intensité. Pour un contenu ordinaire, quelques vérifications de cohérence peuvent suffire. Pour une décision sensible, il faut contrôler les faits et les engagements à partir de sources indépendantes.
La première amélioration consiste à demander un résultat facile à inspecter. Un long texte continu peut masquer les hypothèses utilisées par l’IA. À l’inverse, une réponse structurée permet de séparer ce qui est affirmé, ce qui reste incertain et ce qui doit être confirmé.
Une consigne de contrôle pourrait être : « Présente séparément les faits utilisés, les hypothèses, les chiffres à vérifier et les points nécessitant une décision humaine. N’invente pas de sources et signale explicitement toute information manquante. »
Cette instruction n’empêche pas toutes les erreurs. Elle rend toutefois les affirmations plus faciles à isoler et à confronter aux documents d’origine.
Deux niveaux de vérification permettent d’éviter une procédure inutilement lourde :
- Premier niveau : vérifier la cohérence, la longueur, le ton, le format et l’absence d’éléments manifestement inappropriés. Il convient aux tâches à faible impact.
- Second niveau : contrôler les informations factuelles, les références, les calculs, les engagements et les conséquences possibles. Il s’impose lorsque l’erreur aurait des effets importants.
Un courriel de confirmation simple ne demande pas la même analyse qu’un résumé de contrat. Dans le premier cas, le destinataire, l’objet et le ton peuvent être les principaux points de vigilance. Dans le second, chaque obligation ou condition doit être comparée au document original.
Checklist : valider un résultat produit par l’IA en cinq actions
- Identifier l’usage final : noter si le résultat restera un brouillon, sera partagé ou servira à prendre une décision. Livrable : une destination d’utilisation clairement indiquée.
- Repérer les éléments sensibles : surligner chiffres, noms, dates, références et engagements. Livrable : une liste des points à contrôler.
- Vérifier les faits importants : comparer chaque affirmation sensible à une source indépendante appropriée. Livrable : les affirmations confirmées ou signalées comme incertaines.
- Corriger les passages problématiques : modifier ou supprimer les informations non confirmées. Livrable : une version révisée sans affirmation sensible laissée sans contrôle.
- Autoriser explicitement l’utilisation : effectuer la lecture finale avant partage, publication ou exécution. Livrable : une version validée par la personne responsable.
Cette méthode doit rester proportionnée. Vérifier systématiquement chaque adjectif d’un texte sans conséquence ferait disparaître une partie de l’avantage de l’automatisation. À l’inverse, valider machinalement des résultats sans les lire transforme le contrôle en simple formalité.
Pour maintenir l’attention, il peut être utile de varier périodiquement les éléments examinés en détail. Même les tâches répétitives doivent faire l’objet de contrôles approfondis occasionnels afin de détecter une dégradation ou une erreur devenue habituelle.
La rapidité n’est donc pas le seul indicateur. Le temps réellement gagné correspond au temps de préparation économisé, diminué du temps de vérification et de correction nécessaire.
La même logique peut servir à évaluer un nouvel outil. Au lieu de décider sur la base d’une première démonstration convaincante, mieux vaut observer ses performances dans les conditions réelles d’utilisation, pendant une période limitée.
Comment tester une nouvelle application ou IA pendant une semaine sans perturber son organisation actuelle ?
Pour tester une application d’IA sans désorganiser ses habitudes, il faut sélectionner une ou deux tâches répétitives à faible risque, conserver sa méthode actuelle et comparer les deux approches pendant une semaine. Le test doit mesurer le temps total, la qualité des résultats et la confiance accordée aux réponses, avant toute décision d’adoption.
Une nouvelle application peut donner une excellente première impression simplement parce qu’elle effectue rapidement une tâche inhabituelle. Cette impression devient moins pertinente si les corrections, les vérifications ou les manipulations supplémentaires prennent davantage de temps que prévu.
Le protocole le plus prudent consiste à utiliser l’outil en parallèle, sans modifier immédiatement son organisation. Les fichiers d’origine restent accessibles, les procédures habituelles demeurent disponibles et aucune automatisation irréversible n’est activée pendant l’essai.
Une semaine peut être répartie en trois phases :
- Début de semaine : sélectionner les tâches, définir les critères de réussite et effectuer une première comparaison avec la méthode habituelle.
- Milieu de semaine : répéter les essais avec plusieurs variantes, dont des situations moins favorables à l’outil.
- Fin de semaine : examiner les résultats consignés et décider des usages à conserver ou à abandonner.
Trois indicateurs peuvent être inscrits après chaque essai. Le temps réel comprend la préparation, l’utilisation, les corrections et le contrôle. La qualité perçue correspond à l’adéquation entre le résultat et le besoin initial. La confiance reflète la capacité de vérifier le résultat, et non le caractère convaincant de sa présentation.
Les cas difficiles sont particulièrement instructifs. Il est possible de soumettre une tâche urgente, une consigne comportant plusieurs exigences contradictoires ou un scénario fictif contenant des données sensibles simulées. Ces essais permettent de découvrir comment l’outil réagit lorsque la situation s’écarte du cas idéal.
Il ne faut pas utiliser de véritables informations confidentielles pour éprouver ses limites. Les scénarios doivent rester fictifs et les éventuelles intégrations avec des applications professionnelles doivent respecter les autorisations de l’organisation.
Un tableau de suivi simple aide à conserver des observations comparables.
| Indicateur | Ce qu’il faut noter | Question de décision |
|---|---|---|
| Temps réel | Durée totale avec préparation, corrections et vérification. | L’outil fait-il réellement gagner du temps ? |
| Qualité | Respect des consignes, erreurs constatées et corrections nécessaires. | Le résultat répond-il au besoin ? |
| Confiance | Possibilité de vérifier les affirmations et les données utilisées. | Le résultat peut-il être contrôlé suffisamment ? |
À la fin du test, trois décisions sont possibles. L’adoption complète convient aux tâches étudiées lorsque le bénéfice est régulier et le risque maîtrisé. L’adoption partielle consiste à conserver l’outil uniquement pour les usages où il démontre son intérêt. L’abandon est raisonnable lorsque les erreurs, les coûts ou les contraintes dépassent le bénéfice.
Une adoption partielle peut être particulièrement pertinente : un outil performant pour reformuler des textes n’est pas nécessairement adapté à des calculs importants ou à l’analyse de documents sensibles.
L’essai doit également inclure les précautions de sécurité. Au-delà des fichiers professionnels, certaines informations personnelles apparemment anodines peuvent exposer durablement les comptes de leur propriétaire.
Quelle information personnelle éviter d’utiliser comme réponse de sécurité ?
Il vaut mieux éviter les réponses de sécurité fondées sur des renseignements personnels réels et faciles à retrouver : ville de naissance, école primaire, prénom d’un enfant, date de mariage ou nom d’un animal. Ces informations peuvent être connues de proches, publiées sur les réseaux sociaux ou déduites de plusieurs indices. Une réponse fictive et unique constitue généralement un meilleur choix lorsqu’une telle question est imposée.
Les questions de sécurité ont longtemps été utilisées comme moyen complémentaire de vérification d’identité ou de récupération de compte. Leur faiblesse provient du fait que les réponses ne sont pas nécessairement secrètes.
Une personne peut avoir indiqué son école sur un profil professionnel, partagé une photographie de mariage avec une date ou publié des renseignements sur ses proches. Même si chaque élément semble banal, leur combinaison peut aider un tiers à répondre à une question censée protéger un compte.
Les assistants d’IA ne constituent pas, à eux seuls, la cause de cette fragilité. Ils peuvent toutefois faciliter l’organisation et l’exploitation d’informations accessibles. Il est donc prudent de ne pas communiquer inutilement ses détails personnels à des services en ligne, y compris dans des conversations avec une IA.
Lorsqu’un site impose une question de sécurité, une méthode consiste à employer une réponse aléatoire sans rapport avec la réalité. Par exemple, pour la question « Dans quelle ville êtes-vous né ? », une chaîne fictive unique peut être utilisée au lieu de la véritable ville. Cette réponse doit être enregistrée dans un gestionnaire de mots de passe fiable afin de pouvoir la retrouver.
Il n’est pas nécessaire que la réponse soit géographiquement plausible, sauf si le service applique des contraintes techniques particulières. Sa fonction est de rester secrète, pas de décrire fidèlement la personne.
Une réponse différente pour chaque service limite également les conséquences d’une éventuelle divulgation. Employer partout le véritable nom de son école primaire crée une dépendance commune : si cette information devient connue, plusieurs comptes peuvent être fragilisés.
Lorsque le fournisseur permet de remplacer les questions de sécurité par des mécanismes plus robustes, comme une clé d’accès ou une authentification multifacteur adaptée, il est préférable d’examiner ces options. Les réponses fictives restent une solution de réduction du risque lorsque les questions traditionnelles sont obligatoires.
Enfin, il faut distinguer une information personnelle nécessaire à l’utilisation d’un service d’un renseignement communiqué volontairement dans une conversation. Les deux situations n’impliquent pas les mêmes conditions de traitement, mais la minimisation des données reste pertinente dans chacune d’elles.
Ces précautions limitent l’exposition des renseignements, sans garantir à elles seules leur confidentialité. Une autre protection intervient lors de leur transmission sur internet : le chiffrement, dont il faut comprendre aussi bien l’utilité que les limites.
À retenir avant de transmettre des données à un service d’IA
- Une connexion sécurisée réduit certains risques d’interception, mais ne constitue pas une autorisation de transmettre des renseignements confidentiels.
- La confidentialité dépend aussi des règles du fournisseur, de ses accès techniques et de l’utilisation qu’il fait des données reçues.
- La meilleure protection consiste à combiner un service approprié, une transmission sécurisée et une limitation des informations partagées.
Comment le chiffrement protège-t-il vos données quand elles circulent sur internet, et ce que cela ne couvre pas ?
Le chiffrement protège les données en transformant leur contenu pour empêcher les tiers non autorisés de le lire pendant leur transmission. Sur un site utilisant correctement HTTPS, le protocole TLS sécurise les échanges entre le navigateur et le service. Cette protection ne signifie toutefois pas que l’entreprise destinataire est incapable d’accéder aux informations reçues.
Une analogie permet de comprendre cette distinction. Le chiffrement en transit ressemble à une enveloppe sécurisée qui protège un message pendant son acheminement. Une fois le message arrivé chez son destinataire, celui-ci doit généralement pouvoir en consulter le contenu pour fournir le service demandé.
Avec un assistant d’intelligence artificielle, une connexion HTTPS correctement établie réduit les risques d’interception ou de modification des données par des tiers présents sur le trajet réseau. Elle ne détermine pas combien de temps les messages sont conservés, quels traitements leur sont appliqués ou quelles personnes autorisées peuvent éventuellement y accéder chez le fournisseur.
Deux notions doivent être distinguées :
- Chiffrement en transit : protège les échanges entre des points de communication, notamment à l’aide de TLS sur les connexions HTTPS.
- Chiffrement au repos : protège les données enregistrées sur des supports de stockage contre certains types d’accès non autorisés, selon les mécanismes et la gestion des clés utilisés.
Dans les deux cas, l’efficacité dépend de la configuration technique et de la gestion des accès. Des données peuvent être chiffrées pendant leur transmission et leur stockage, tout en restant accessibles au fournisseur lorsqu’il possède les moyens nécessaires pour les traiter.
Le chiffrement de bout en bout constitue une situation différente : lorsqu’il est correctement mis en œuvre, seuls les points de communication autorisés disposent des clés permettant de déchiffrer le contenu. Il ne faut toutefois pas supposer qu’un assistant d’IA généraliste offre cette propriété simplement parce que son site utilise HTTPS.
Pour un utilisateur canadien, deux contrôles simples peuvent améliorer les pratiques de transmission :
- Vérifier le site et la connexion : s’assurer que l’adresse correspond bien au service voulu et que la connexion utilise HTTPS sans alerte de sécurité du navigateur. L’icône de cadenas, lorsqu’elle est affichée, n’atteste pas à elle seule de la fiabilité du fournisseur.
- Privilégier un environnement réseau maîtrisé : utiliser de préférence une connexion de confiance et suivre les mesures de sécurité de l’organisation pour les usages professionnels. Un réseau Wi-Fi public peut présenter des risques supplémentaires, même si HTTPS correctement utilisé protège le contenu des échanges contre de nombreuses interceptions locales.
Ces vérifications ne suffisent pas si les informations transmises ne devraient pas quitter l’organisation. La protection du canal et l’autorisation de communiquer le contenu sont deux questions distinctes.
Avant d’utiliser un assistant pour une tâche sensible, il reste nécessaire de consulter les conditions applicables au service, ses engagements de confidentialité et les politiques internes de l’employeur. Pour des données personnelles, les obligations légales pertinentes doivent également être prises en compte.
Pour commencer dès aujourd’hui, choisissez une tâche simple, préparez une consigne sans données sensibles, produisez un premier brouillon et vérifiez-le avant de l’utiliser. Si le résultat est utile et que le contrôle reste rapide, cette tâche pourra devenir un usage régulier de l’IA, sans lui céder la responsabilité de vos décisions.
Peut-on utiliser une IA gratuitement pour des tâches professionnelles ?
Le caractère gratuit d’un service ne détermine pas son autorisation en entreprise. Il faut consulter les politiques de l’employeur et les conditions de traitement des données du fournisseur. Pour les tâches contenant des informations confidentielles, un outil expressément approuvé par l’organisation est nécessaire.
Comment savoir si une réponse d’IA mérite une vérification approfondie ?
Une vérification approfondie s’impose lorsque la réponse contient des faits déterminants, des références documentaires, des chiffres importants ou des recommandations pouvant produire des conséquences juridiques, financières, médicales ou professionnelles. Le critère principal est le risque associé à une erreur, et non la confiance apparente du modèle.
Est-il préférable de demander à l’IA de citer ses sources ?
Oui, lorsque la tâche repose sur des informations factuelles. Les références proposées facilitent potentiellement la vérification, mais leur présence ne prouve pas leur authenticité. Il faut ouvrir les documents originaux, confirmer qu’ils existent et contrôler qu’ils soutiennent réellement les affirmations présentées.
Faut-il prévenir les destinataires lorsqu’un texte a été préparé avec une IA ?
Cela dépend du contexte, des règles professionnelles, des engagements contractuels et des obligations éventuellement applicables. La transparence peut être particulièrement importante lorsque l’utilisation de l’IA influence substantiellement une décision ou lorsque des règles imposent une divulgation. Dans tous les cas, la personne qui approuve le texte doit en assumer le contenu et vérifier les informations communiquées.
Comment éviter de devenir dépendant d’un assistant IA ?
Il est utile de conserver ses méthodes de travail essentielles, de savoir réaliser manuellement les vérifications importantes et de réévaluer régulièrement les tâches déléguées. L’assistant doit soutenir la compréhension et l’exécution, plutôt que remplacer systématiquement la réflexion. Une utilisation partielle et ciblée peut apporter davantage de valeur qu’une automatisation généralisée.